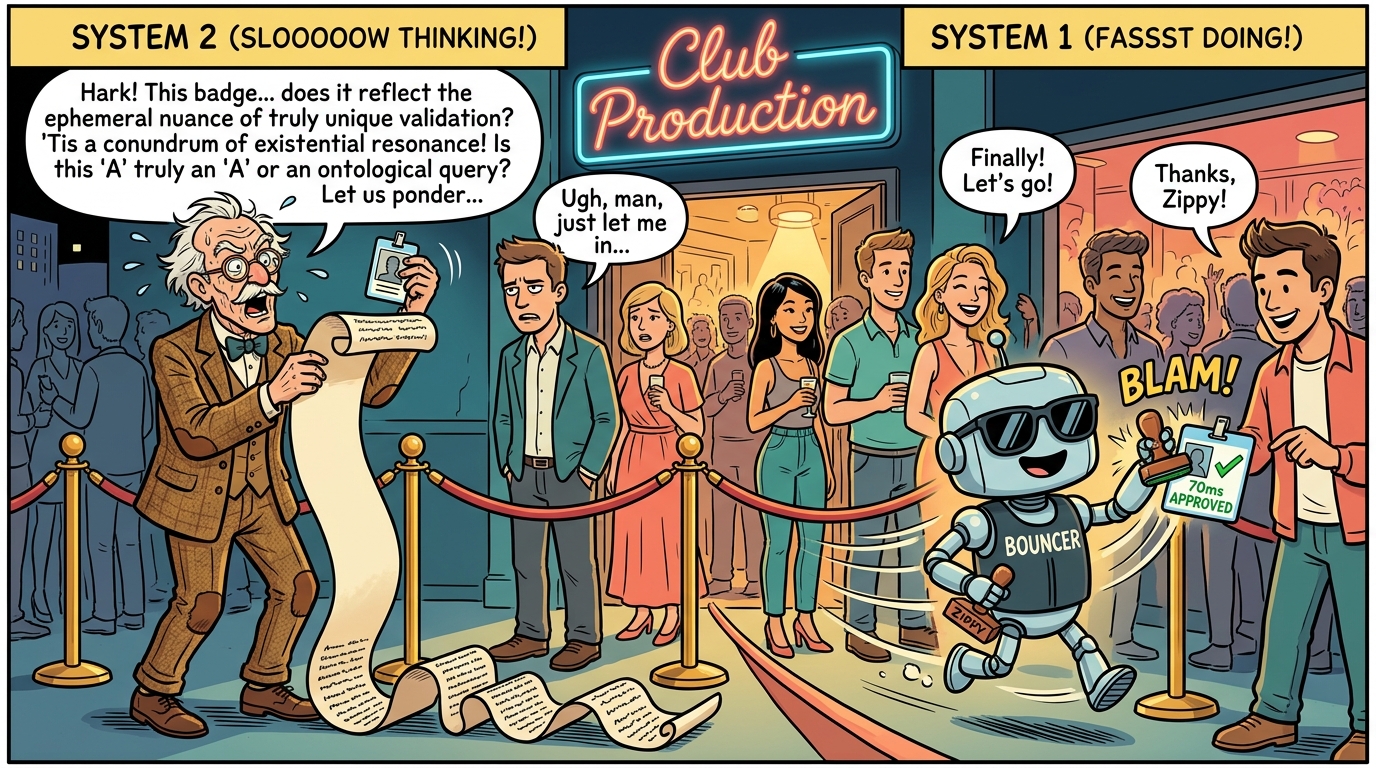
Tänk dig att du anställer en nobelpristagare i litteratur för att stå i dörren på nattklubben och kontrollera legitimation.
Varje gång en gäst kommer fram ber du nobelpristagaren bedöma om personen är över 18 år. Pristagaren funderar i 15 sekunder och svarar med en vackert formulerad essä i tre stycken om ungdomens förgänglighet och tidens flykt – innan hen slutligen avslutar med: {"approved": true}.
Vi har tagit enorma minneskrävande språkmodeller – tränade på hela internet, Shakespeares samlade verk och miljarder parametrar – och tvingat dem att fungera som dörrvakter, filter och trafikpoliser. Vi promptar dem med “Svara endast i giltig JSON” bara för att få veta om ett supportärende är brådskande eller om en SQL-fråga är säker att köra.
Nu utmanas detta mönster på allvar.
Möt Jev: AI:n som vägrar skriva text
I mitten av september släppte TypeSafe AI (grundat av tidigare OpenAI-forskaren Diogo Almeida) sin modell Jev i tidig access.
Jev är vad skaparna kallar en ren “System One”-modell. Till skillnad från vanliga LLM:er som genererar text ord för ord (autoregressivt) genererar Jev inte en enda bokstav prosa:
- Icke-generativ arkitektur: Du matar modellen med ett tillstånd (JSON eller råtext) och ställer en typad fråga i kod (flerval, poängskala eller sant/falskt).
- Parallell utvärdering: Modellen besvarar frågan i ett enda parallellt beräkningssvep och returnerar en strukturerad sannolikhetsfördelning direkt till din applikation.
Resultatet är siffror som får en traditionell LLM-stack att se ut som en relik från förr:
- Hastighet: Svarstider på 70 till 500 millisekunder – vilket är 20x till 200x snabbare än en generativ modell.
- Kostnad: $0,042 per miljon input-tokens.
- Gratis output: Svaret kostar noll kronor eftersom modellen inte spottar ur sig långa textströmmar (“too cheap to meter”).
- Total kalkyl: TypeSafe AI rapporterar att Jev är 40x till 400x billigare för klassificering och avgränsade beslut än vanliga språkmodeller.
Modellens namn är för övrigt en direkt blinkning till ekonomen William Stanley Jevons och Jevons paradox: När kostnaden och latensen för ett beslut rasar mot noll kommer antalet autonoma mikrobeslut i våra system inte att minska – det kommer att explodera.
Ersättare i dörren – Komplement i verkstaden
Betyder detta att de stora språkmodellerna är döda? Självklart inte. Men deras roll förändras i grunden:
1. Där Jev helt kan ersätta
För ren klassificering, ärenderouting, sentimentanalys och policykontroller är en textgenererande LLM onödig.
2. Där Jev är det perfekta komplementet
Den verkliga arkitektoniska kraften uppstår när vi kopplar ihop dem.
I moderna agentflöden och automatiserade pipelines kan Jev agera blixtsnabb reflex och grindvakt (System 1). Jev granskar indata, verifierar behörigheter och stoppar riskfyllda anrop på 80 ms. Först när en fråga godkänts och kräver kreativ problemlösning eller kodgenerering skickas den vidare till en tung generativ modell eller en resonemangsmodell (System 2).
Frågorna varje arkitekt måste ställa sig
Den här utvecklingen tvingar oss att ställa två grundläggande frågor som många organisationer hittills duckat för:
1. Är hastighet på svar viktigt?
I en vanlig chattbubbla på en webbplats spelar det kanske ingen roll om svaret dröjer två sekunder. Men vad händer när du bygger autonoma agenter som kör i loopar, eller realtidsfilter som ska granska tusentals händelser i sekunden? Skillnaden mellan 100 millisekunder och 3 sekunder är inte en bekvämlighetsfråga – det är skillnaden mellan ett system som kan integreras i en interaktiv användarupplevelse och ett system som havererar under sin egen latens.
2. Är kostnad per fråga viktigt?
När ett team experimenterar med AI på labbstadiet är API-kostnaden en avrundningsmiss. Men när applikationen rullas ut i skarp drift och ska utvärdera varje inkommande loggrad, varje e-post och varje databasförfrågan blir ekonomin plötsligt en överlevnadsfråga. Om en fråga kostar $0,001 mot $0,000002 är det inte en marginell justering – det är skillnaden mellan en månadsfaktura på 100 000 kr och en på 200 kr.
Hur ser det ut i era egna system i dag? Använder ni fortfarande en fullstor språkmodell för att fatta enkla ja/nej-beslut i bakgrunden, eller har ni börjat dela upp arkitekturen i snabba reflexer och djupa tankar?
— Andreas, Staff Architect